

Hostinger annonce des notifications pour ses tâches planifiées. Sur un VPS, la question pratique est similaire : quel résultat faut-il surveiller et à qui signaler un échec ? Commencez par un contrôle de service systemd que vous savez interpréter.
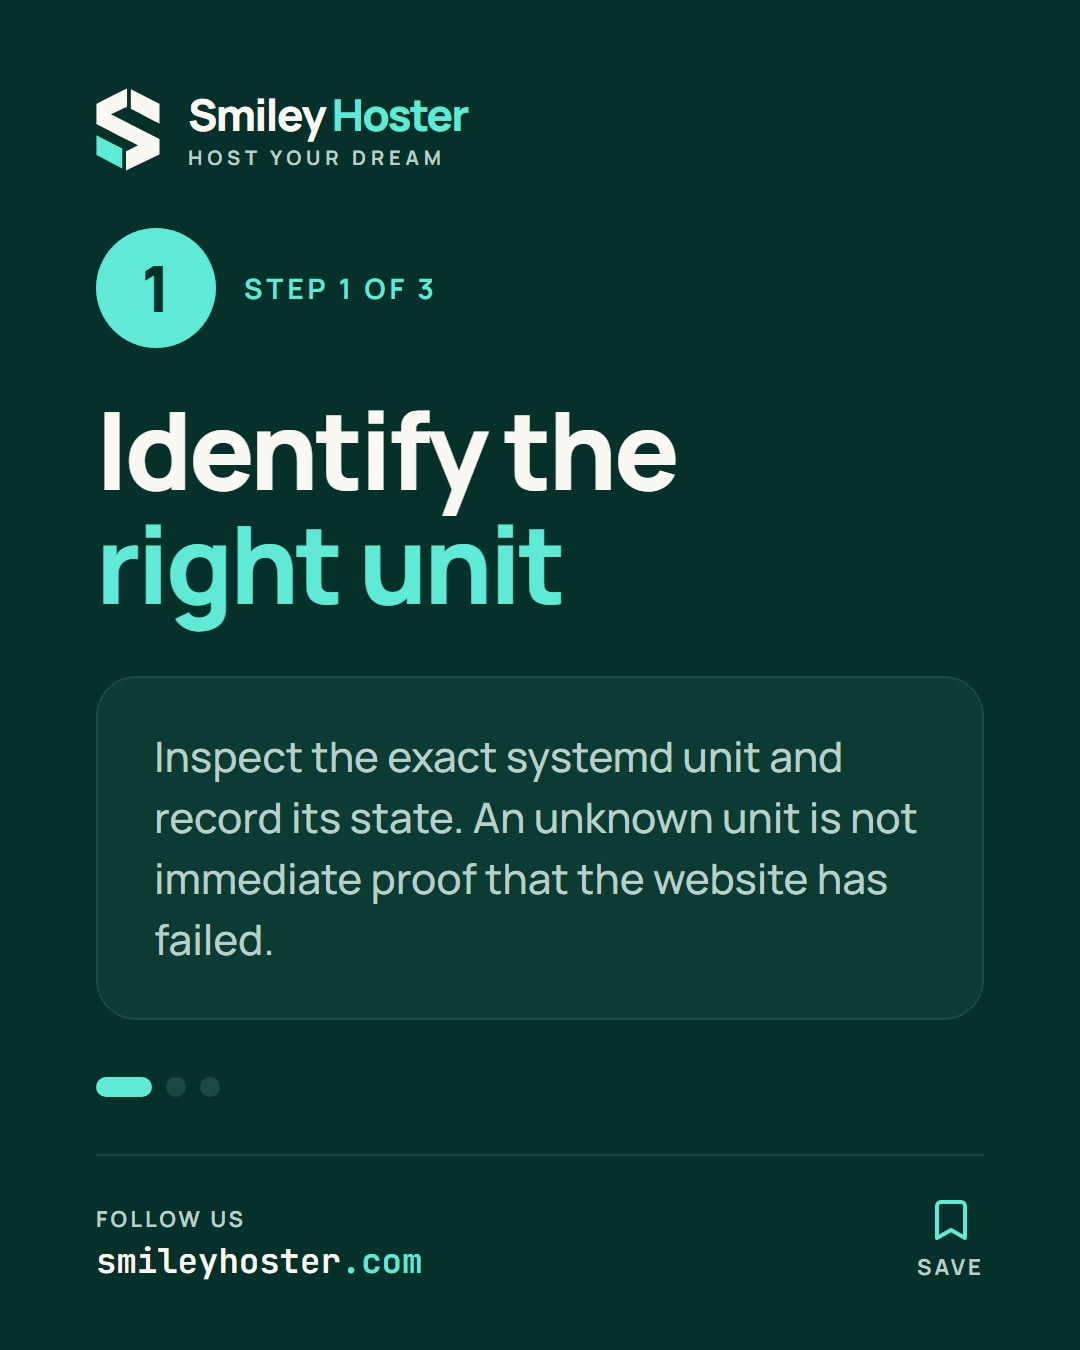
1. Choisir le bon service
Ce guide s'adresse aux serveurs Linux utilisant systemd. Il ne remplace pas les contrôles propres à un conteneur ou à une application gérée autrement. Dans les exemples, nginx.service désigne le serveur web ; remplacez ce nom par l'unité qui correspond réellement à votre installation.
Exécutez un premier contrôle dans votre session SSH :
systemctl status nginx.service --no-pagerNotez le nom exact de l'unité et son état. Si elle est introuvable, vérifiez votre inventaire avant de conclure à une panne. Si elle est désactivée au démarrage, cela n'indique pas à lui seul si elle fonctionne maintenant.
Écrivez ce que vous voulez protéger : accès au site, traitement des commandes ou réception d'une requête. Vous éviterez ainsi de surveiller un processus sans relation claire avec le service rendu au client.
2. Construire un signal que vous comprenez
Pour un test simple utilisable par un script, interrogez une seule unité :
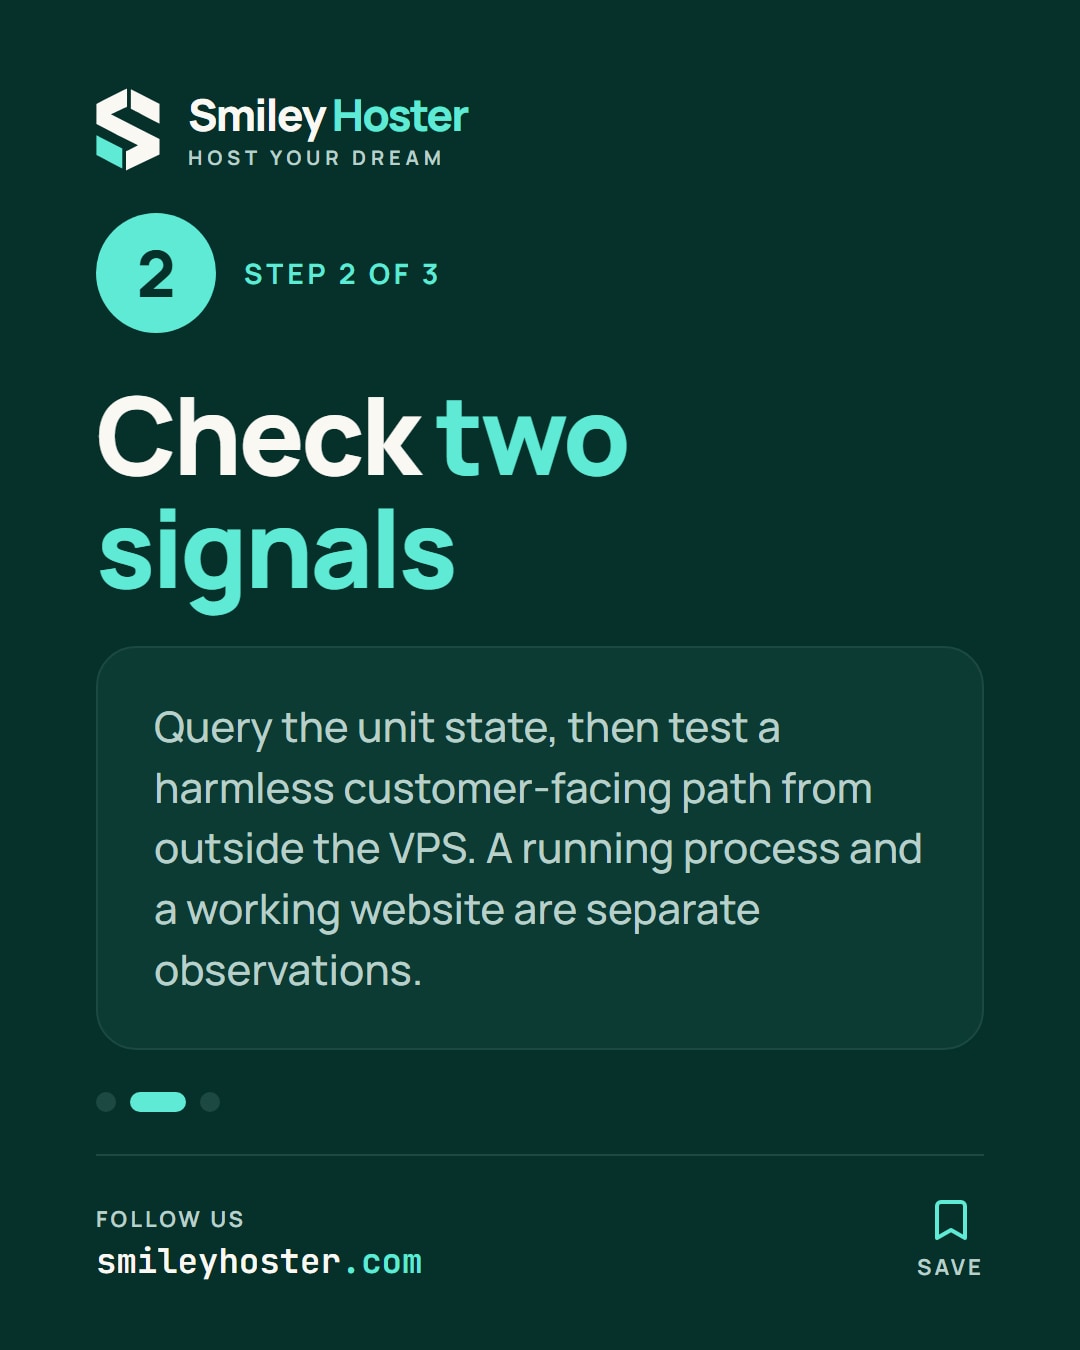
systemctl is-active --quiet nginx.serviceecho $?Le code zéro indique que l'unité est active ; un autre résultat appelle une investigation. La sortie silencieuse est normale. Pour obtenir une vue lisible des unités en échec :
systemctl --failed --no-pagerNe déclenchez pas un redémarrage automatique à partir de cette seule observation. Relevez d'abord l'heure, le nom de l'unité et le contexte du dernier changement. Effacer l'état d'échec avant de le comprendre peut compliquer votre diagnostic.
Complétez ensuite le contrôle local par un essai extérieur : ouvrez une page utile du site et réalisez une action de test sans effet métier. Un processus actif ne prouve pas que le parcours utilisateur fonctionne. Gardez les deux observations dans votre fiche.
3. Préparer une alerte exploitable
Dans votre outil de surveillance existant, associez le contrôle à un destinataire et à une procédure courte. Prévoyez aussi le cas où le serveur ne répond plus : un contrôle local ne peut alors plus annoncer son propre résultat.
Testez le circuit de notification sur un environnement d'essai ou avec la fonction de test de l'outil, sans arrêter le site de production. Vérifiez la réception, puis le signal de retour à la normale. Choisissez la fréquence selon le délai de détection attendu et les contraintes de votre application.
Une fiche utile contient le serveur, l'unité, l'heure, le résultat local, le résultat extérieur et la personne responsable. Si le service est actif mais le site échoue, transmettez ces deux faits ensemble. Vous disposez alors d'un signal précis pour enquêter, plutôt que d'un simple voyant vert.
Sources : Hostinger, systemd — documentation de systemctl.
Retrouvez-le dans nos publications
Les étapes clés de cet article, en carrousel. Suivez-nous pour découvrir les prochaines. Nos publications sont rédigées en anglais.